声音克隆效果不像?多半是样本没录好:一份 20 秒录音指南
克隆出来的声音发闷、有杂音、不像本人,问题大多出在那段样本上。这篇讲清楚样本该录多长、在哪录、怎么读,以及上传后质量检查的每条提示该怎么处理。
经常有人问:为什么我克隆出来的声音听着闷闷的,背景里还带着一层沙沙声,或者语气和本人差得挺远?
我们翻过不少这样的反馈,大部分时候问题不在模型,而在上传的那段样本。模型会把样本里的一切都当成「你的声音」来学,包括空调声、房间回声、手机外放的失真。样本里有什么,克隆结果里就会有什么。
好消息是,录一段合格的样本并不难。你不需要专业麦克风,一部手机加一个安静的房间就够了。下面把我们总结的经验按顺序讲一遍。
先说结论:10 到 30 秒,安静、连续、正常说话
如果你只想记住一句话,就是这句。
- 时长:10–30 秒最合适。少于 3 秒无法克隆;8 秒以下相似度会明显下降;超过 1 分钟也不会更好,反而更容易混进杂音和停顿。
- 环境:越安静越好。关窗、关空调、远离冰箱和电脑风扇。
- 内容:连续说话,中间不要有长时间的空白。
- 语气:用你平时说话的状态,不要刻意播音腔,也不要压着嗓子。
接下来细说每一点为什么重要。
录音之前:花两分钟准备环境
很多人会低估房间的影响。人耳会自动忽略背景里的低频嗡嗡声,但模型不会。
几个容易被忽略的噪声来源:
- 空调、新风、电脑风扇这类持续的低频噪声
- 窗外的车流和施工
- 空旷房间的回声(四面白墙、硬地板的房间尤其明显)
一个简单的办法:去卧室或者衣柜旁边录。窗帘、被子、衣服都能吸收回声,效果往往比空荡荡的客厅好很多。
如果用手机录,把手机放在嘴前 20–30 厘米的位置,别贴着嘴,也别放得太远。贴太近容易「喷麦」,也容易破音;太远则音量偏低,房间的声音占比会变大。
读什么:用你平时会说的话
样本的内容其实没那么讲究,但有两条建议:
- 读一段完整的话,而不是零散的词。模型需要学习你说话的节奏和语调,一段连贯的叙述比「一、二、三、测试」有用得多。
- 语言和你之后要生成的内容保持一致。打算用中文配音,就录中文样本。
如果一时想不到读什么,可以直接用页面上的示例文稿。在克隆页切到「在线录制」,上方会给出一段约 20 秒的文字,中英文都有,读起来自然,长度也刚好合适。
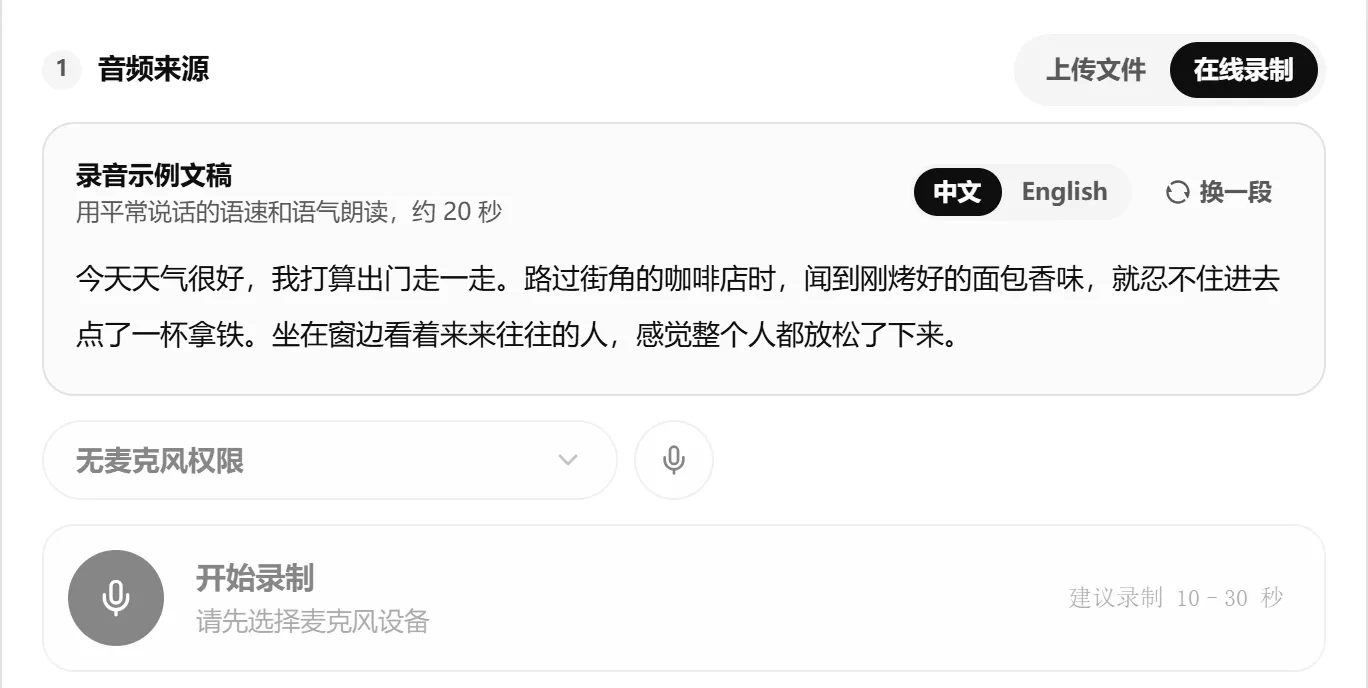
朗读的时候,像给朋友讲一件小事那样说就行。不用追求字正腔圆,你平时怎么说话,克隆出来的声音就会是什么样子,这正是我们想要的。
上传之后:看懂质量检查的提示
在 声音克隆页面 上传或录完音频后,页面会立刻在浏览器里检查一遍样本,不需要等提交。检查结果分两种:
- 橙色的提示:可以继续创建,但效果可能会打折扣
- 红色的提示:样本不合格,需要重新录或换一个文件
下面这个例子是我们故意做的一段「反面样本」:用手机外放录下的会议发言,音量开得太大,中间还停了 4 秒多。
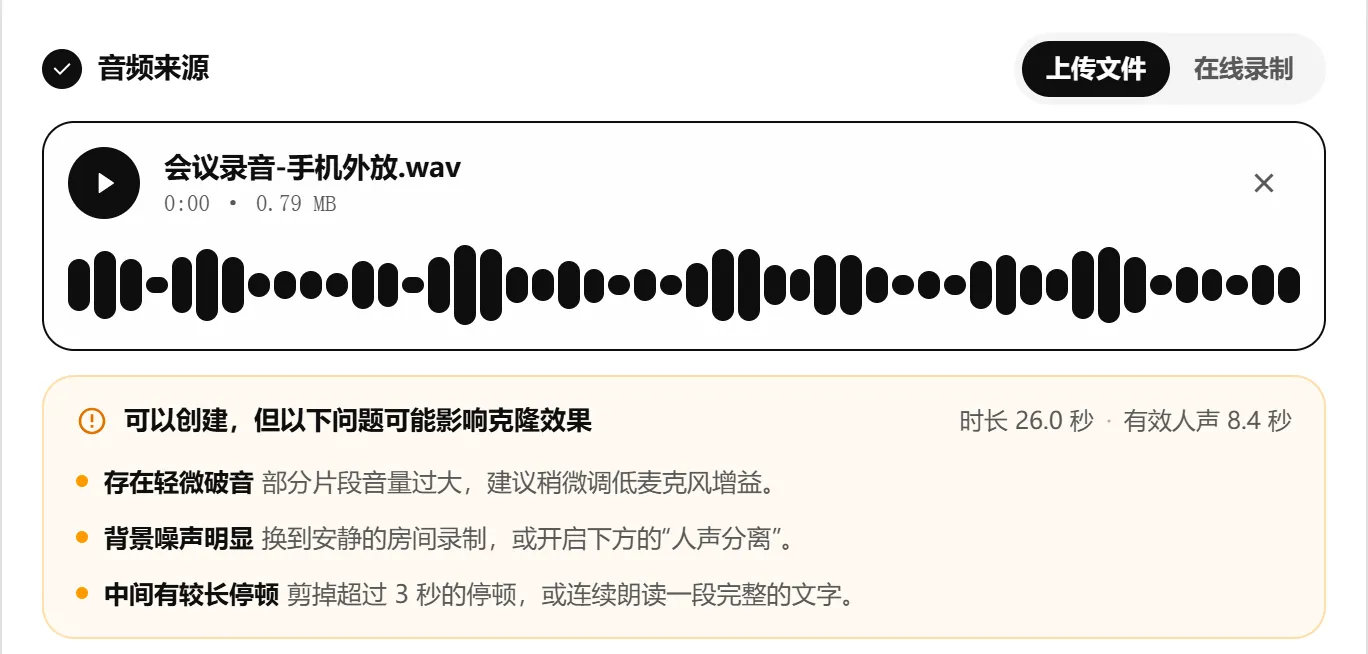
一共 26 秒的音频,有效人声只有 8.4 秒,其余都是停顿和噪声。检查给出了三条提示,逐个说一下怎么处理:
存在轻微破音:录音音量太大,声音的波峰被「削平」了,听起来会有毛刺感。把麦克风增益调低,或者离麦克风远一点再录。如果破音很严重,检查会直接判定为不合格。
背景噪声明显:人声和背景噪声的差距不够大。最有效的办法还是换个安静的地方重录;实在没条件,可以在下方「其他设置」里打开「人声分离」,系统会尝试去掉背景声。不过去噪多少会损失一些细节,能重录就别依赖它。
中间有较长停顿:样本中间出现了超过 3 秒的空白。把停顿剪掉,或者干脆连续读一段完整的文字。
另外还有几种常见提示:
| 提示 | 原因 | 怎么办 |
|---|---|---|
| 音频太短 | 不足 3 秒 | 至少录 10 秒 |
| 音频偏短 | 8 秒以下 | 补录到 10–30 秒 |
| 音频偏长 | 超过 1 分钟 | 截取最干净的 10–30 秒 |
| 音量偏低 | 离麦克风太远或输入音量太小 | 靠近一点,或调高输入音量 |
| 未检测到清晰人声 | 麦克风静音或选错了设备 | 检查设备后重录 |
同样的内容,换成在安静房间里正常音量录的版本,检查结果就干净多了:
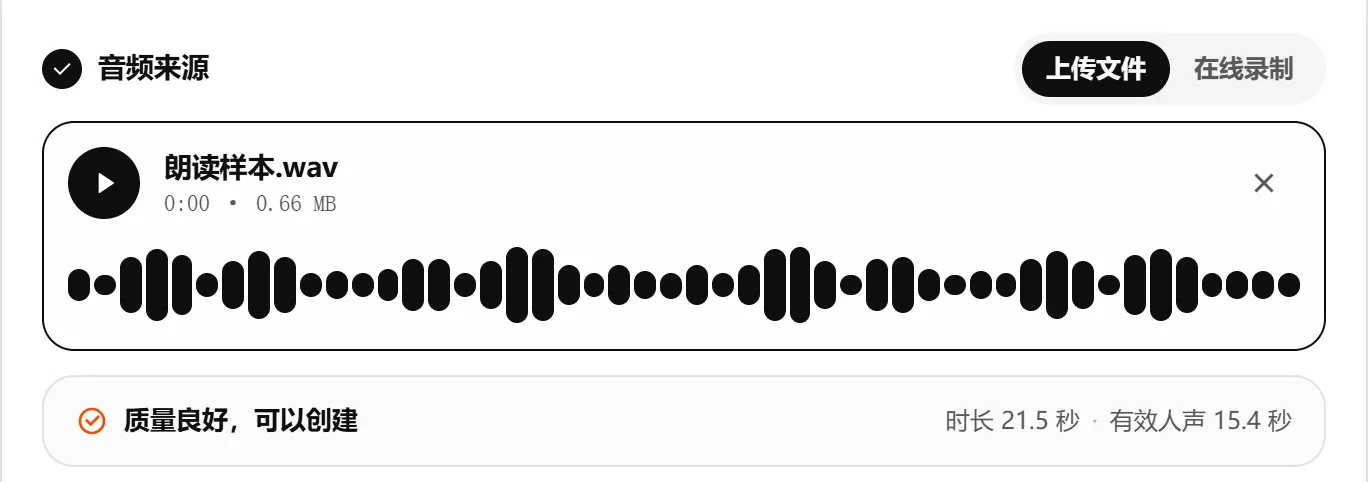
21.5 秒的音频里有 15.4 秒是有效人声,没有任何提示。这就是一段合格的样本。
几个常见的误区
「样本越长,效果越好」
不是。超过 1 分钟之后,效果基本不会再提升,反而更容易混进咳嗽、翻页声和长停顿。与其上传一段 5 分钟的会议录音,不如从里面挑出最干净的 20 秒。
「用视频里截出来的音频也可以」
可以,但要挑没有背景音乐、没有其他人说话的片段。背景音乐是最难处理的一类噪声,即使开了人声分离也很难去干净。
「声音要尽量饱满有磁性」
刻意压低嗓音或者用播音腔,克隆出来的就是那个刻意的声音,之后生成的每一句话都会带着这种腔调,听久了很累。用平常的状态说话,效果反而最自然。
准备好了就试试
整个流程大概是这样:
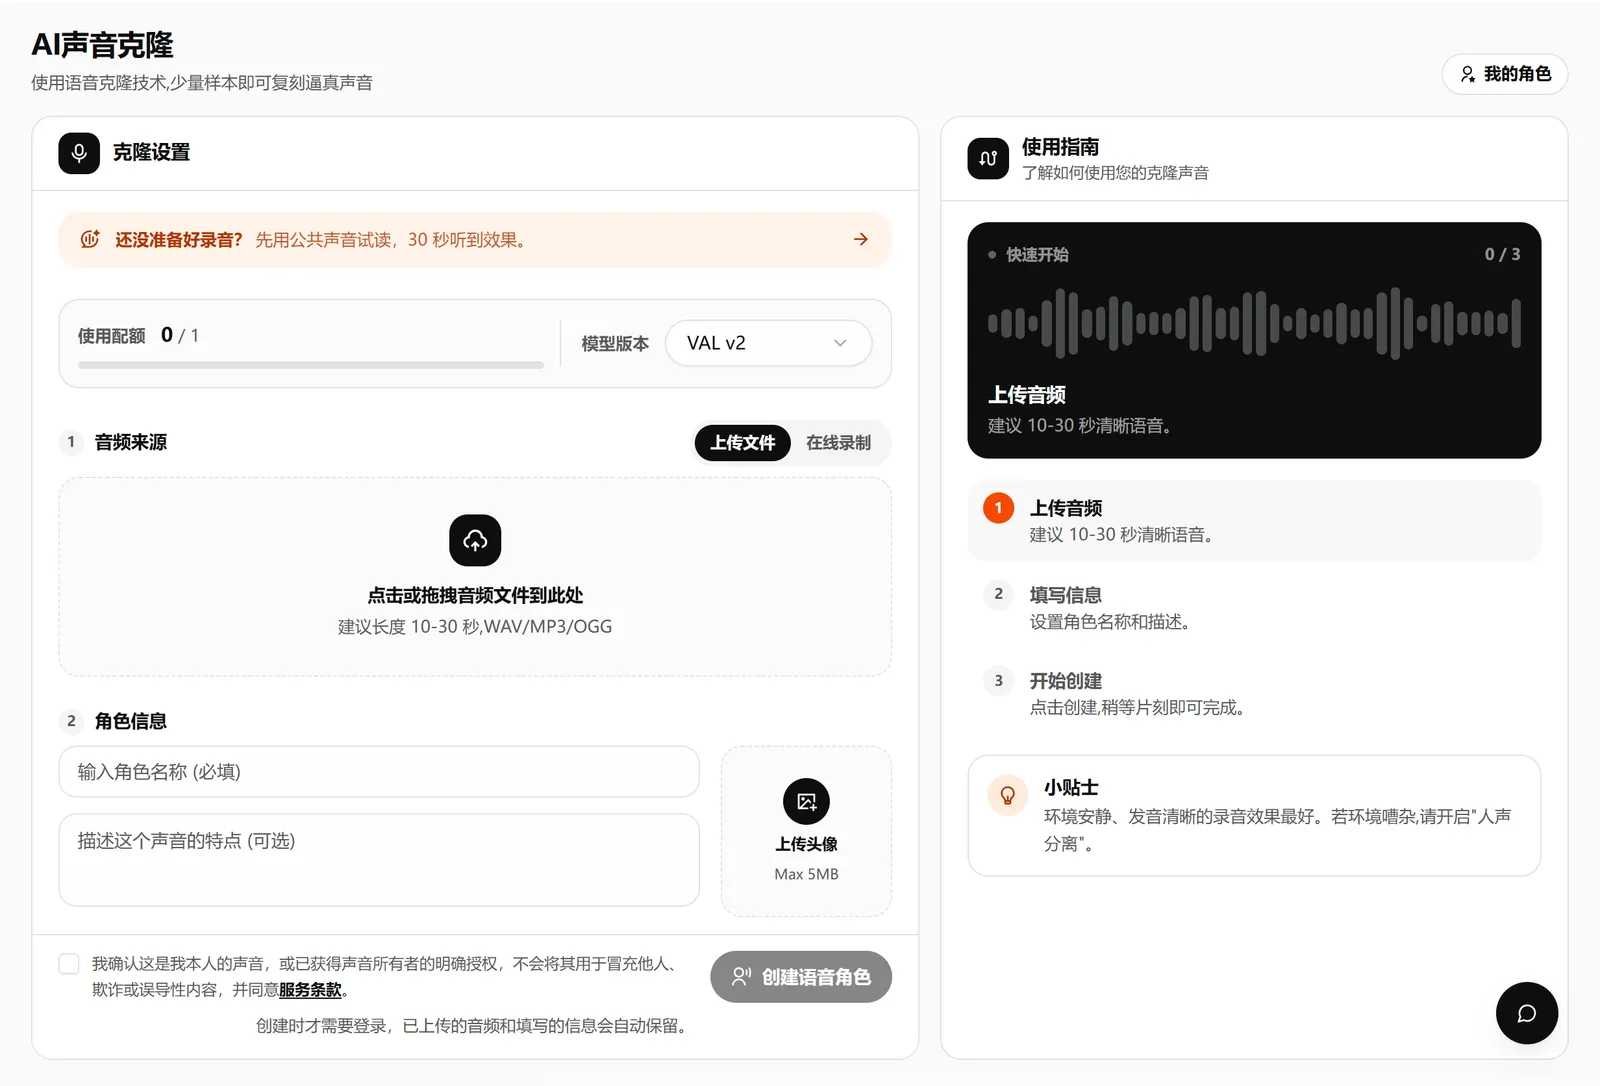
- 打开 声音克隆,选择「上传文件」或「在线录制」
- 看一眼质量检查,有提示就按建议调整
- 填写角色名称,勾选授权声明,点击创建
创建完成通常只需要 20 秒左右。之后就可以在 文本配音 里用这个声音朗读任意文字,也可以在 配音项目 里给长篇内容配音。
最后提醒一句:只克隆你自己的声音,或者已经得到本人明确授权的声音。这既是平台规则,也是对别人基本的尊重。
如果还没准备好录音,也可以先去 声音广场 挑一个公共声音试试效果。